AI가 글을 여러 편 만들고 게시까지 도왔다면, 실제 운영도 맡길 수 있다고 봐도 될까요? 10월 20일 마감 기준 공개 페이지까지 확인된 글은 4편, 원고·도식·검토를 마쳤지만 게시하지 않은 글은 1편이었습니다. 09시 실행은 두 원고를 만들고 검토에 넘겼지만 자동 발행은 하지 않았고, WorkBuddy 시험도 일부 요청만 평가할 수 있었습니다.
게시일은 2026년 10월 21일, 기록 대상은 10월 20일입니다. 집계 범위는 10월 20일 03:00 이후부터 23:52:32 KST까지입니다. 네 편은 이 구간의 새 네이버 콘텐츠이며, 03:47에 공개된 직전 마감 기록 자체는 별도 자료로 제외했습니다.
마감표: 공개와 준비를 분리
| 마감 상태 | 콘텐츠 | 확인 근거 |
|---|---|---|
| 공개 1–2 | Claude Code Review 정식 출시, 움직이는 태아의 MRI | 09:00 실행이 09:16 KST에 원고 2편과 검토를 반환. 11:06 KST에 두 공개 페이지를 확인. 실행 종료와 공개 확인은 별도 단계입니다. |
| 공개 3 | WorkBuddy에서 DeepSeek 시험 | 13:37 KST에 공개 페이지·이미지·출처 링크 확인. |
| 공개 4 | SynthID 확인법 | 마감 전 공개 완료 보고 및 공개 페이지 결과 확인. 보고 시각은 18:05 KST이며, 이를 실제 게시 시각으로 간주하지 않습니다. |
| 준비 1 · 미게시 | 전기장판 소비전력·안전 가이드 | 원고·도식·검토는 PASS였지만 23:52:32 KST 마감까지 공개되지 않았습니다. |
아침의 진척: 실행은 됐고, 발행은 별도였다
09:00 실행은 09:00 KST에 시작해 09:16 KST에 Claude Code Review와 MIT의 태아 MRI 촬영 보조 기사 초안 두 편, 검토 결과를 AI 편집 담당에게 반환했습니다. 그 시점의 상태는 원고 준비와 검토 완료였고, 게시 수는 0이었습니다. 이어 11:06 KST의 별도 공개 확인에서 두 페이지가 열리는 것을 확인했습니다. 이번에 확인된 개선은 정해진 시각의 실행이 실제 원고·검토까지 진행됐다는 점이지, 자동 발행이 된 것이 아닙니다.
두 기사의 효용도 과장하지 않았습니다. Claude Code Review 글은 Anthropic이 밝힌 내부 성과를 회사 자체 집계라고 구분하고, 공개 제품이 PR을 승인하거나 코드를 실행하는 것은 아니라고 설명합니다. MRI 글은 AI가 진단 대신 움직이는 태아 머리의 방향 추정과 촬영을 돕는다는 점을 구분하고, 임상 결과나 진단 개선이 입증됐다고 말하지 않습니다.
WorkBuddy 시험: 통과한 요청과 답을 못 받은 요청
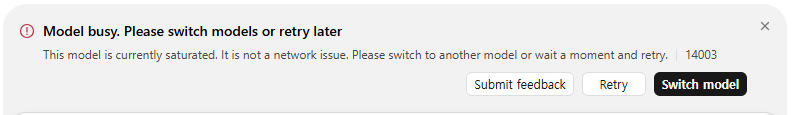
사용자는 WorkBuddy 링크와 설치·무료 사용 시험 방향을 제시했습니다. 담당 AI가 앱을 실제로 열어 Deepseek-V4.1-Flash를 확인하고, 짧은 요약과 작은 코드 요청을 시험했습니다. 이 이름은 앱 표시 라벨이며 실제 응답 백엔드는 독립 확인하지 못했습니다. 요약은 합성 메모의 숫자를 맞췄고, 코드는 격리 환경에서 여덟 사례를 통과했습니다. 반면 추론 문항과 불확실성 문항은 앱에 “Model busy”가 떠 응답을 받지 못했습니다. 이는 두 문항을 평가할 수 없었다는 뜻이지, 통과나 실패 판정이 아닙니다.
앱에 표시된 크레딧은 시험 전후 모두 349.6이었습니다. 이 잔액 관측은 이번 화면의 계정 크레딧이 같았다는 사실만 말해 줍니다. 사람 시간, AI/API 사용량, 구독료를 포함한 총비용이 0이었다는 뜻은 아닙니다.
첫 채널 전달은 AI가 잘못 선택했고 사용자가 바로잡았습니다. 잘못 인계된 Yulchive 경로에는 실제 배포가 0건인 상태로 중단했고, WorkBuddy 글은 정정된 게시 방향에 따라 기존 공개 블로그에서 확인됐습니다. 여기서 중요한 것은 “AI가 알아서 올렸다”가 아니라, 목적지가 어긋났을 때 멈추고 사람의 정정을 반영했다는 점입니다.
저녁의 경계: 공개된 SynthID, 준비만 끝난 전기장판 글
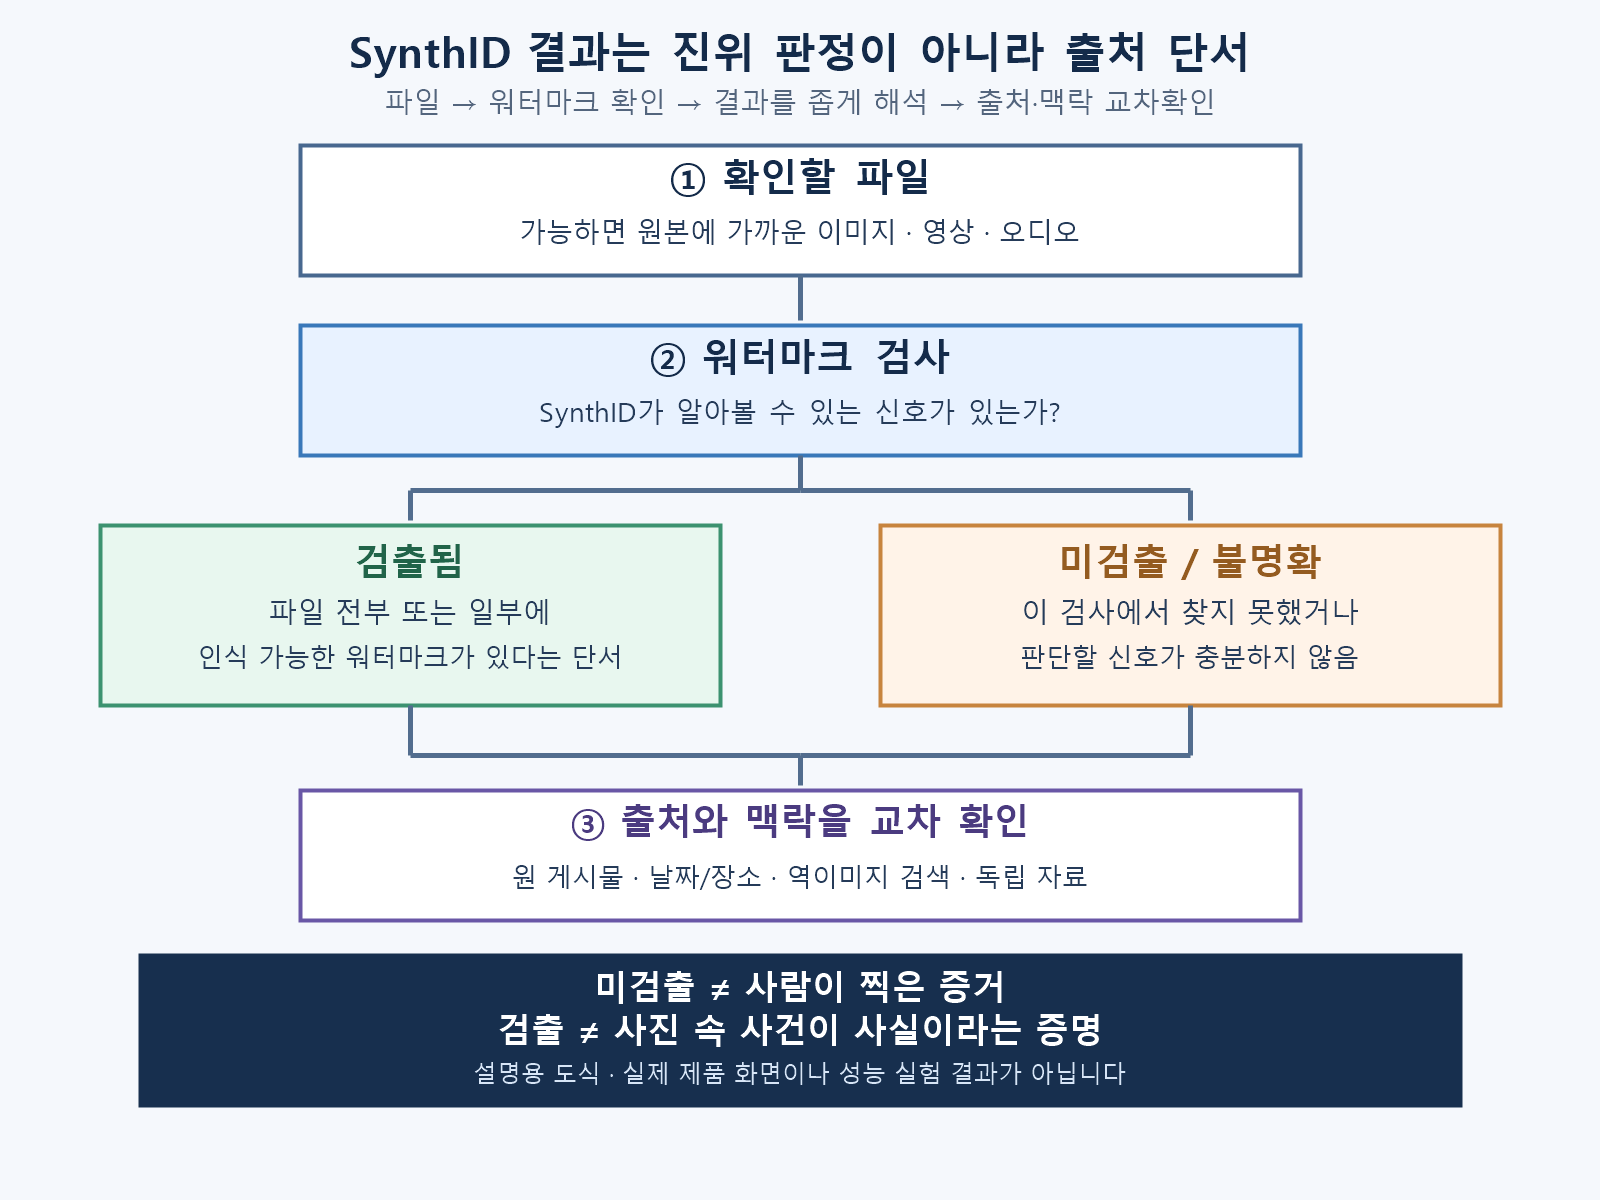
저녁에는 SynthID 결과를 읽는 법을 다룬 글이 공개됐습니다. 핵심은 ‘미검출’이 진짜 사진이라는 증명이 아니라, 확인한 도구가 알아볼 워터마크를 찾지 못했다는 뜻이라는 점입니다. 글의 도식도 실제 판별 성능이나 실험 결과가 아니라 확인 순서와 해석의 범위를 설명합니다.
같은 저녁, 전기장판 소비전력·안전 가이드는 원고와 도식, 검토를 마쳤지만 마감까지 공개 상태가 되지 않았습니다. 게시 단계에서 브라우저 연결이 응답하지 않아 게시가 멈췄으며, 연결 장애의 정확한 원인은 확인하지 못했습니다. 준비 완료는 게시 완료가 아니므로 이번 공개 수에는 넣지 않았습니다.
누가 무엇을 했나
사용자는 WorkBuddy 시험을 요청하고 잘못된 게시 방향을 정정했습니다. 담당 AI는 자료 조사, 원고 작성, 앱 시험과 코드 확인을 맡았습니다. 별도 검토에서는 아침 두 원고와 저녁 두 원고의 사실·도식 범위를 확인했고, Aside AI 편집 담당이 최종 원고를 검토해 지정된 공개 블로그에 게시한 뒤 공개 페이지를 확인했습니다. 각 단계는 서로 바꿔 말할 수 없습니다. 초안·검토 PASS·게시·공개 확인은 각각 다른 결과입니다.
아직 숫자로 말할 수 없는 것
마감까지 전체 작업 경과와 사람 총투입시간은 측정하지 않았습니다. AI/API 전체 사용량과 구독 총비용도 집계하지 않았습니다. 조회·유입·전환·매출 역시 측정되지 않았습니다. 따라서 이번 공개 4편을 수익 성공이나 완전 무인 운영의 증거로 부르지 않습니다. WorkBuddy 크레딧이 349.6으로 같았던 관측도 총비용 계산을 대신하지 않습니다.
다음 발행에 적용할 5단계
- 대상 확인: 글을 쓰기 전에 주제, 게시 채널, 공개 범위와 최종 승인자를 확인합니다. 경로가 다르면 잘못된 경로를 중지합니다.
- 근거 확인: 출처와 날짜를 대조하고, 시험은 통과·실패·응답 없음/평가 불가로 나눠 기록합니다.
- 미리보기 확인: 제목·본문·그림·링크를 실제 모바일 폭에서도 확인하고, 계정·인증 정보가 화면이나 원고에 들어가지 않았는지 봅니다.
- 공개 확인: 검토 PASS나 예약 등록을 게시로 세지 않습니다. 실제 공개 페이지와 본문·이미지를 확인하고 확인 시각과 게시 시각을 구분합니다.
- 측정 기록: 사람 시간, AI/API·구독 비용, 앱 크레딧, 노출·클릭·전환·수익을 각각 기록합니다. 한 항목의 숫자를 다른 항목의 대용으로 쓰지 않습니다.
다음 실험에서 가장 먼저 수치로 남겨야 할 것은 총 작업시간, AI/API·구독비용, 아니면 공개 뒤 유입·전환 중 무엇일까요?